Bot-Flut auf einem WordPress-Kalender: Erkennung und Gegenmaßnahmen
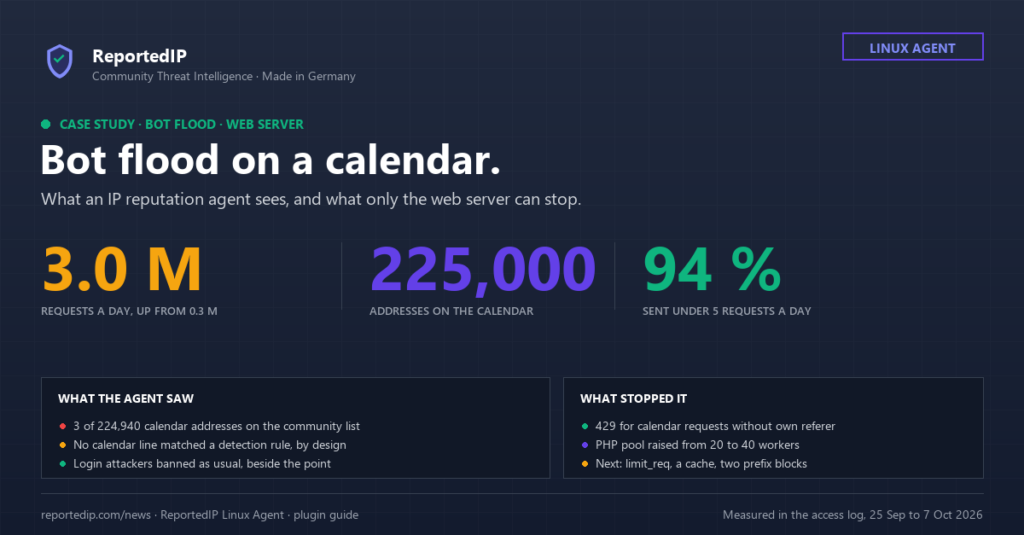
Eine WordPress-Site mit Veranstaltungskalender auf einem Shared-Hosting-Server sprang von unter 400.000 Anfragen am Tag auf rund drei Millionen, der PHP-Pool lief voll und Besucher bekamen 502-Fehler. Der ReportedIP Agent auf demselben Server las jede Zeile dieser Bot-Flut und sperrte ihretwegen keine einzige Adresse; diese Anleitung erklärt, warum das richtig war und was die Flut stattdessen stoppte.
Die Zahlen stammen aus dem Access-Log der Site vom 25. September bis 7. Oktober 2026 und aus einer Messung auf fünf Webservern. Das Hostingteam sah 38.870 gescheiterte Verbindungen zu PHP in 200.000 Zeilen Fehlerlog. Der Agent sah gewöhnliche Seitenaufrufe.
Was ist auf der Kalender-Site passiert?
Bis zum 28. September bediente die Site bis zu 364.000 Anfragen am Tag, die meisten davon Aufrufe des Kalenderfilters /events/?mcat=… aus dem Plugin My Calendar. Am 29. September um 07:00 UTC sprang die Zahl je Stunde von 15.360 auf 86.240, eine Stunde später auf 187.994. Die Kalender-Anfragen blieben gleich; der Sprung kam allein aus den Seiten-Assets.
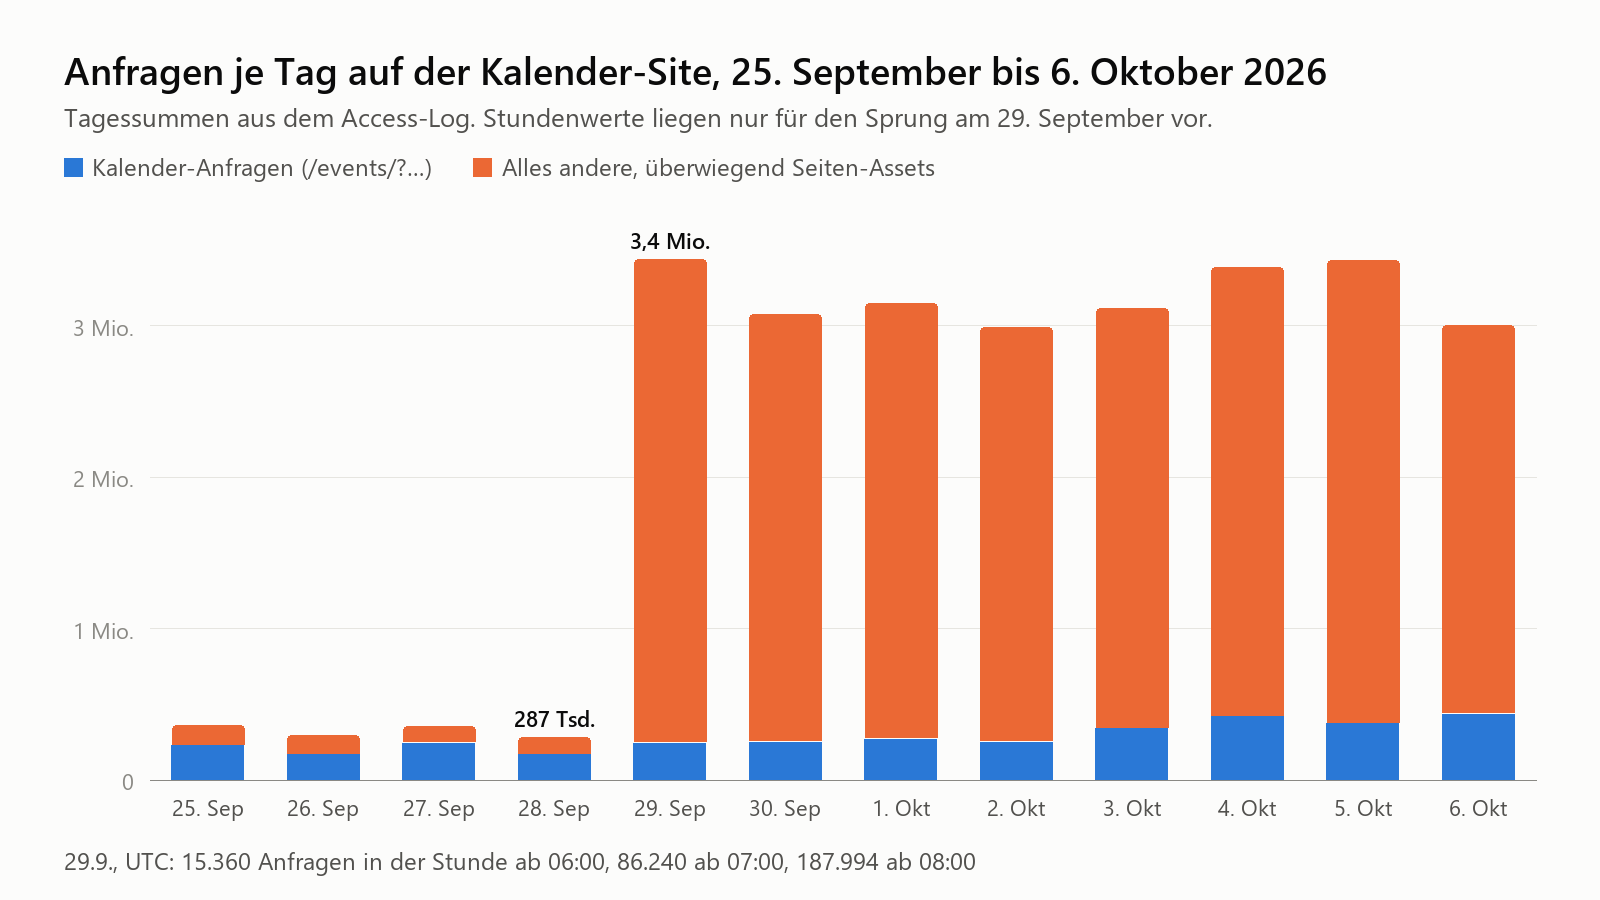
Der PHP-Pool erlaubte 20 Worker und stieß am 6. Oktober 75 Mal an diese Grenze; der Kalender beantwortete an dem Tag 30.129 Anfragen mit 502. Acht Tage lang schlug kein Alarm an. Dann verdoppelte das Hostingteam den Pool und stellte eine Regel vor den Kalender.
Welche Bots standen hinter der Bot-Flut?
Der Kalender-Crawl über Residential-Proxies
Der erste Strom lief jede Kombination aus Kalenderkategorien, Tagen und Monaten ab. Am 6. Oktober schickten 224.940 Adressen 432.855 Kalender-Anfragen. Die meisten Adressen tauchten einmal auf und nie wieder.
| Kalender-Crawl, 6. Oktober | Wert |
|---|---|
| Adressen | 224.940 |
| Adressen mit weniger als 5 Anfragen am ganzen Tag | 94,1 % |
| Anfragen je Adresse, Median | 1 |
| Anfragen je Adresse, 99. Perzentil | 12 |
| Anfragen je Adresse, Maximum | 3.094 |
| Verschiedene /24-Netze | 125.482 |
| Anfragen mit Referer der eigenen Site | 0,3 % |
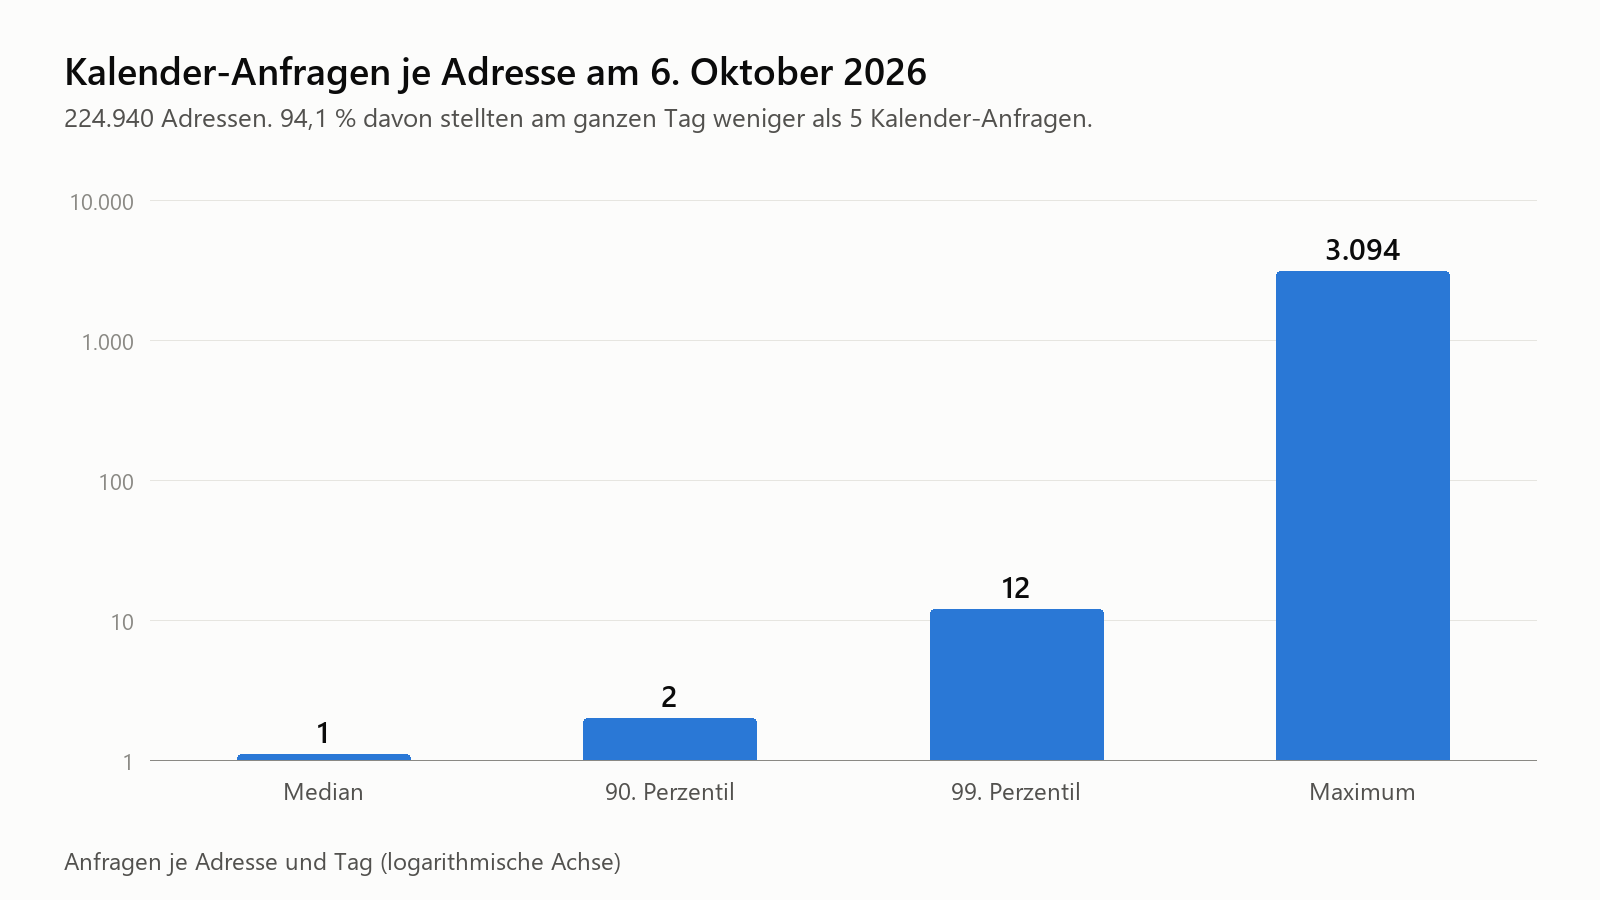
Das größte /16-Netz hielt 0,8 Prozent der Adressen. Diese Streuung über Festnetz- und Mobilfunkanschlüsse ist das Kennzeichen eines Residential-Proxy-Pools. Die sechs häufigsten User-Agents gaben sich alle als Chrome auf macOS aus, doch nur 987 Kalender-Adressen luden an dem Tag überhaupt ein Asset.
Die Asset-Flut aus zwei gemieteten Blöcken
Der zweite Strom rief die Assets gewöhnlicher Seiten ab, mit der Adresse der Site als Referer, so wie ein Browser. Er machte am 6. Oktober 84,6 Prozent aller Logzeilen aus.
| Asset-Flut, 6. Oktober | Wert |
|---|---|
| Asset-Anfragen | 2.543.994 |
| Adressen | 28.520 |
| Anfragen mit Referer der eigenen Site | 99,8 % |
| Assets je Adresse, Median | 70 |
| Anteil aus 154.222.128.0/20 | 21,1 % |
| Anteil aus 154.217.192.0/20 | 19,1 % |
| Anteil der fünf häufigsten User-Agents | 48,9 % |
Fünf User-Agents mit fast gleicher Anzahl sind eine rotierte Liste, kein echtes Publikum. Im ersten /20-Block zeigte jedes /24 252 oder 253 aktive Adressen: ein gemieteter Block, bis zur letzten Adresse ausgenutzt. Und die Seiten zu diesen Assets tauchen im Log kaum auf, 29.281 Seitenaufrufe gegen 2,5 Millionen Assets.
Warum hat der IP-Reputationsagent die Bot-Flut nicht gestoppt?
Weil eine erfolgreiche Anfrage auf eine gewöhnliche Seite nie ein Angriff ist, und der Agent ist absichtlich so gebaut. Seine Web-Quelle zählt Login-POSTs, Scannerpfade und Proben, die mit einem Fehler enden. Kalender-Anfragen mit 200, 499 oder 502 passen auf nichts davon, und der Web-Erkenner verwirft Assets, bevor er sie ansieht. Ein Erkenner, der Seitenaufrufe zählt, sperrt echte Besucher.
Die Community-Liste kannte 3 der 224.940 Kalender-Adressen und 1 der 28.520 Asset-Adressen; frische Proxy-Ausgänge stehen noch auf keiner Liste. Währenddessen tat der Agent seine normale Arbeit: 2.066 lokale Sperren in viereinhalb Tagen für Passwortraten, Scannerproben und SSH-Angriffe über alle Sites des Servers. Richtig, und am Thema vorbei.
Was kann der Agent gegen einen Kalender-Crawl tun?
Er kann den harten Kern herausnehmen. Sechzehn Adressen aus Rechenzentrumsnetzen schickten je 1.162 bis 3.094 Kalender-Anfragen, langsam und gleichmäßig, etwa drei je Minute über sieben bis vierzehn Stunden. Eine eigene Regel sieht die ganze Logzeile samt Query-String und Referer und kann genau diese Anfragen zählen. Seit 0.3.43 lässt sich eine Regel zuerst simulieren: Sie schreibt simulated ban ins Log, statt zu sperren. Seit 0.3.45 läuft eine eigene Regel vor den mitgelieferten Regex-Regeln derselben Quelle; bis 0.3.44 konnte eine mitgelieferte, nur simulierende Regel ihr die Zeilen vorher wegnehmen.
Der Block examples am Ende ist der Selbsttest der Regel, keine Liste von Zielen. Jede match-Zeile muss treffen und die angegebene Adresse liefern; die inject-Zeile legt Köderadressen in URL und User-Agent, und die Regel muss trotzdem die Adresse des Clients lesen; nomatch-Zeilen dürfen nicht zählen. Der Agent führt diese Prüfungen beim Laden der Datei aus und weist die Regel ab, wenn eine scheitert. Im Betrieb sperrt die Regel jede Adresse aus dem echten Log, die 10 Treffer in 60 Minuten erreicht. Die Datei unten ist die Regel, die jetzt auf zwei betroffenen Kalender-Sites läuft. Sie ist dort scharf geschaltet (simulate: false), weil sie zuerst simuliert lief und ihre Treffer gemessen wurden.
# /etc/reportedip-agent/rules.d/60-calendar-crawl.yaml
format: 1
rules:
  - id: calendar-crawl
    source: web
    match:
      regex: '"GET /[^" ]*\?[^" ]*mcat=[^"]*" [0-9]{3} [0-9]+ "(-|https?://(www\.)?(google|bing)\.[^"]*)" "Mozilla/[^"]*"$'
      anchors:
        - '"GET /'
      ignore:
        - 'mc_id='
        - '"[^"]*([Bb]ot|[Cc]rawl|[Ss]pider|Barkrowler|Turnitin|GoogleOther)[^"]*"$'
    addr: {field: 0}
    threshold: {hits: 10, window_minutes: 60}
    categories: [19]
    noun: calendar crawl requests
    action:
      ban: true
      report: false
      time_minutes: 60
      simulate: false
    # Self-test, not a target list: checked when the file loads; in operation the rule bans any address that reaches 10 hits in 60 minutes.
    examples:
      match:
        - {line: '45.33.32.156 - - [06/Oct/2026:12:00:00 +0000] "GET /events/?cid=my-calendar&dy=29&mcat=6%2C5%2C7&time=day HTTP/2.0" 200 5120 "-" "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7)"', addr: 45.33.32.156}
        - {line: '45.33.32.157 - - [06/Oct/2026:12:00:01 +0000] "GET /events/?mcat=7,1,12,3,8 HTTP/1.1" 429 162 "https://www.google.com/" "Mozilla/5.0 (Linux; Android 10; K)"', addr: 45.33.32.157}
        - {line: '45.33.32.158 - - [06/Oct/2026:12:00:02 +0000] "GET /kalender/?cid=my-calendar&mcat=6%2C5&yr=2026 HTTP/2.0" 200 5120 "-" "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/118.0.0.0 Safari/537.36"', addr: 45.33.32.158}
      inject:
        - {line: '45.33.32.156 - - [06/Oct/2026:12:00:03 +0000] "GET /events/?mcat=1&x=8.8.8.8 HTTP/1.1" 200 5120 "-" "Mozilla/5.0 8.8.4.4"', addr: 45.33.32.156}
      nomatch:
        - '45.33.32.156 - - [06/Oct/2026:12:00:10 +0000] "GET /events/?mcat=1 HTTP/2.0" 200 5120 "-" "RetroDocumentResearch/0.1"'
        - '45.33.32.156 - - [06/Oct/2026:12:00:04 +0000] "GET /events/?mcat=1 HTTP/2.0" 200 5120 "https://example.org/events/" "Mozilla/5.0"'
        - '45.33.32.156 - - [06/Oct/2026:12:00:05 +0000] "GET /kalender/?mc_id=123&mcat=1 HTTP/2.0" 200 5120 "-" "Mozilla/5.0"'
        - '45.33.32.156 - - [06/Oct/2026:12:00:06 +0000] "GET /kalender/?cid=my-calendar&mcat=6%2C5&yr=2026 HTTP/2.0" 200 5120 "-" "Mozilla/5.0 (compatible; Barkrowler/0.9; +https://babbar.tech/crawler)"'
        - '45.33.32.156 - - [06/Oct/2026:12:00:07 +0000] "GET /events/?mcat=1 HTTP/2.0" 200 5120 "-" "Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)"'
        - '45.33.32.156 - - [06/Oct/2026:12:00:08 +0000] "GET /events/?cid=my-calendar HTTP/2.0" 200 5120 "-" "Mozilla/5.0"'
        - '45.33.32.156 - - [06/Oct/2026:12:00:09 +0000] "POST /events/?mcat=1 HTTP/2.0" 200 5120 "-" "Mozilla/5.0"'
Die Regel zählt jede Anfrage mit mcat= im Query-String, auf jedem Pfad, passt also zu Kalendern unter /events/ ebenso wie unter /kalender/, und mit jedem Status, damit ein Crawl, den der Webserver schon mit 429 beantwortet, weiter zählt. Sie zählt nur Anfragen ohne Referer oder mit Google oder Bing als Referer: Ein Besucher, der sich durch zwanzig Filter klickt, trägt den Referer der eigenen Site und zählt nie, und ein Link auf einen einzelnen Termin (mc_id) bleibt außen vor. Die Regel zählt nur Clients, deren User-Agent mit Mozilla/ beginnt, wie ihn jeder Browser und jeder getarnte Crawler sendet; ein Crawler oder Werkzeug, das sich mit eigenem Namen nennt, zählt nie, auch eines ohne ein Wort wie bot im Namen, wie wir es live gesehen haben, und die Namensliste fängt die Crawler, die ebenfalls mit Mozilla/ beginnen, etwa Googlebot. report: false hält den Crawl aus dem Community-Feed heraus, time_minutes: 60 verdoppelt die erste Sperre, und die Eskalationsleiter vervierfacht sie bis zu sieben Tagen. Prüfen Sie die Datei mit reportedip-agent rules check, testen Sie sie an einem Tag Log mit reportedip-agent test <log> --rule calendar-crawl und beginnen Sie auf Ihrer eigenen Site mit simulate: true, bis die Treffer stimmig aussehen.
Am 6. Oktober erreichten, gemessen an einem ersten Entwurf mit 20 Anfragen je Stunde, höchstens 69 Adressen diese Marke, und sie schickten 9,4 Prozent der Kalenderlast. Die übrigen 90 Prozent kommen von Adressen, die höchstens ein paar Mal fragen und verschwinden, und keine Zählung je Adresse trennt sie von Menschen.
Warum erklärte Crawler nicht gesperrt werden
Wir haben eine ähnliche, breitere Regel (jeder Query-String, nur Status 200) auf fünf Servern über zwei Tage gemessen. Bei 20 Anfragen in 60 Minuten traf sie 53 Adressen: keinen Menschen und kein Monitoring, aber 35 SEO- und KI-Crawler, eine echte Suchmaschine, ein Werkzeug und 16 Bots, die sich als Browser oder als bekannter Crawler ausgaben. Auf der betroffenen Site fing diese breitere Regel 46 der 69 schweren Adressen, darunter alle 16 aus Rechenzentren. Unsere Entscheidung: Eine Crawl-Regel zählt nur Clients, die sich als Browser ausgeben. Ein Crawler, der sich mit Namen nennt, kann ein SEO-Dienst sein, den der Betreiber der Site selbst gebucht hat, darum überspringt ihn die zweite ignore-Zeile.
Benannte Crawler zu überspringen ist eine Richtlinie, keine Sicherheitsprüfung. In der Messung stand eine Adresse, die sich aus einem Hosting-Netz als Googlebot ausgab, und die Regel lässt sie durch; die Login- und Scanner-Erkenner zählen sie weiter. Eine echte Ausnahme für Suchmaschinen braucht eine Reverse-DNS-Prüfung, nie den User-Agent. Für einen Health-Check, der nie zählen soll, reicht eine Zeile in /etc/reportedip-agent/ignore.d/web.conf, siehe Zeilen, die eine Quelle nie sehen soll.
Wer wird gesperrt, und wer nicht?
Mit der scharf geschalteten Regel auf beiden Sites wurde die 429-Notbremse im Webserver entfernt, und wir haben die folgende Stunde beobachtet, am 7. Oktober von 13:11 bis 14:11 UTC. Site A ist die Kalender-Site aus diesem Fall, Site B eine zweite WordPress-Site mit demselben Kalender-Plugin.
| Wer | Gesperrt | Warum |
|---|---|---|
| Sechs Adressen eines Cloud-Anbieters, alle mit demselben User-Agent Chrome auf macOS | Ja | Crawlten den Kalender seit Mitternacht, je 156 bis 402 Kalender-Anfragen an dem Tag, kein eigener Referer, keine Logins, keine POSTs |
| Eine Adresse eines zweiten Cloud-Anbieters, Android-User-Agent | Ja | Ein Crawler, der sich als Browser ausgibt, mit gefälschtem Google-Referer |
| Erklärte Crawler wie Googlebot, bingbot, PetalBot, GPTBot, Reflectionbot und Barkrowler | Nein | Ein Crawler, der sagt, wer er ist, ist eine Richtlinienfrage für den Betreiber der Site, kein Angriff. Es zählen überhaupt nur User-Agents, die mit Mozilla/ beginnen, und die Namensliste überspringt Crawler wie Googlebot, die ebenso beginnen |
| Menschen, die Kalenderfilter anklicken | Nein | Sie schicken die Site selbst als Referer |
| Der eigene Server der Site und das Monitoring | Nein | Stehen immer auf der Whitelist |
| Der lange Schwanz des Schwarms | Nein | Tausende Adressen mit je einer Handvoll Anfragen; keine Regel je Adresse fängt sie, ohne Menschen zu treffen |
Die Präzision lag bei 7 von 7: kein Mensch, kein guter Bot, und niemand musste entsperrt werden. Nach ihrer Sperre schickten die sieben Adressen in dieser Stunde keine weitere Anfrage.
Die Wirkung auf die Last ist klein, und das gehört zum Bild. Auf Site A machten die sieben Adressen 1,2 Prozent der Kalender-Anfragen dieser Stunde aus, 70 von 5.901. Auf Site B kam kein Crawler über 9 Anfragen je Adresse und Stunde, also unter die Schwelle, während ein erklärter KI-Crawler allein 28 Prozent der Kalenderlast erzeugte. Die Regel lässt diesen Crawler in Ruhe; ihn zu sperren entscheidet der Betreiber der Site, im Webserver oder in der robots.txt. Keine der beiden Sites beantwortete in dieser Stunde eine Anfrage mit 5xx, und der PHP-Pool von Site A nutzte höchstens 14 seiner 40 Worker.
Die Regel entfernt die lauten Crawler, die sich als Browser ausgeben, mit nahezu sicherer Präzision. Der Schwarm und die erklärten Crawler gehören in den Webserver, mit Ratenbegrenzung und Cache, und in die Crawler-Richtlinie des Site-Betreibers.
Der Agent liest jedes Vhost-Log eines Linux-Servers, sperrt, was seine Regeln benennen, und synchronisiert die Community-Blacklist in den Kernel. Eigene Regeln laufen neben den mitgelieferten.
Wie stoppen Sie eine Bot-Flut in nginx?
Alles, was Last unabhängig vom Absender begrenzt, gehört in den Webserver. Die Ausschnitte unten sind allgemein gehalten; passen Sie Pfad, Domain und Zahlen an Ihre Site an. Die Einzelheiten jeder Direktive stehen in der nginx-Dokumentation zu limit_req.
Den Kalender als Ganzes mit limit_req begrenzen
Eine Zone je Adresse richtet gegen 225.000 Adressen mit je einer Anfrage nichts aus; die vorhandene Zone des Servers mit 100 Anfragen je Sekunde und Adresse griff nie. Hilfreich ist eine Zone mit festem Schlüssel: Dann sieht PHP nie mehr als eine festgelegte Zahl von Kalender-Anfragen je Sekunde, egal wie viele Adressen sie schicken.
# http {}
limit_req_zone $binary_remote_addr zone=calendar_ip:10m rate=1r/s;
limit_req_zone $server_name        zone=calendar_all:1m rate=10r/s;

# server {}
location ^~ /events/ {
    limit_req zone=calendar_ip  burst=5  nodelay;
    limit_req zone=calendar_all burst=20;
    limit_req_status 429;
    try_files $uri $uri/ /index.php?$args;
}
Den Kalender mit dem Query-String im Schlüssel cachen
Ein FastCGI-Cache mit der vollständigen Anfrage-URI als Schlüssel beantwortet wiederholte Filteraufrufe ohne PHP. Er speichert nichts, solange WordPress Set-Cookie oder Cache-Control: no-cache sendet; die Stellschraube dafür ist fastcgi_ignore_headers. Bei praktisch unbegrenzten Filterkombinationen bleibt die Trefferquote begrenzt, kombinieren Sie ihn deshalb mit weniger Kombinationen: Filterlinks mit rel="nofollow", den Filterpfad in der robots.txt oder Filter per Skript statt per Link.
# http {}
fastcgi_cache_path /var/cache/nginx/calendar levels=1:2 keys_zone=calendar:10m max_size=1g inactive=10m;

# inside the PHP location of the server
set $skip_cache 1;
if ($request_uri ~ "^/events/\?") { set $skip_cache 0; }
if ($http_cookie ~* "wordpress_logged_in|wp-postpass|comment_author") { set $skip_cache 1; }
fastcgi_cache        calendar;
fastcgi_cache_key    "$scheme$request_method$host$request_uri";
fastcgi_cache_valid  200 5m;
fastcgi_cache_lock   on;
fastcgi_cache_bypass $skip_cache;
fastcgi_no_cache     $skip_cache;
Kalender-Anfragen ohne eigenen Referer mit 429 beantworten
Diese Regel hat das Hostingteam als Notbremse eingeschaltet. Am 6. Oktober kamen 99,7 Prozent der Kalender-Anfragen ohne den Referer der eigenen Site. In der ersten vollen Stunde mit der Regel bekamen 29.170 von 29.208 Kalender-Anfragen eine 429. Sie hält nur, bis der Bot den Referer fälscht, was der Asset-Strom schon tut.
# http {}
map $http_referer $own_referer {
    default 0;
    "~^https://(www\.)?example\.org/" 1;
}
map "$own_referer:$arg_mc_id:$args" $calendar_brake {
    default 0;
    "~^0::.+" 1;   # no own referer, no single event, but a query string
}

# server {}, inside location ^~ /events/
if ($calendar_brake) { return 429; }
Gemietete Präfixe nach einer whois-Prüfung sperren
Die beiden /20-Blöcke trugen 40 Prozent der Asset-Flut. Prüfen Sie den Inhaber zuerst per whois: Einen Hosting-Anbieter können Sie als Ganzes sperren, einen Zugangsanbieter für Privatkunden nicht.
# server {}, only after whois names a hosting provider
deny 154.222.128.0/20;
deny 154.217.192.0/20;
Eine Bot-Challenge oder einen vorgeschalteten Dienst davorsetzen
Einen Headless-Browser von einem Menschen zu unterscheiden braucht JavaScript oder Fingerprinting, und das kann weder ein Log-Leser noch nginx. Ein Reverse-Proxy mit Bot-Challenge oder eine Challenge vor dem Kalenderfilter ist der letzte Schritt, wenn die Referer-Bremse nicht mehr hält.
Checkliste für Betreiber eines WordPress-Kalenders
- Beobachten Sie die Anfragen je Vhost und Stunde, nicht nur das Fehlerlog.
- Trennen Sie im Access-Log Kalender-Anfragen, Assets und Seiten, bevor Sie handeln.
- Prüfen Sie, ob die Clients Assets laden. Crawler, die sich als Browser ausgeben, tun das meist nicht.
- Legen Sie eine
limit_req-Zone mit festem Schlüssel auf den Filterpfad. - Cachen Sie den Filterpfad mit dem Query-String im Cache-Schlüssel.
- Nehmen Sie Filterlinks mit
nofollowundrobots.txtaus dem Crawl. - Setzen Sie 429 für Anfragen ohne eigenen Referer nur als Notbremse ein.
- Sperren Sie ein Präfix erst, wenn whois einen Hosting-Anbieter zeigt.
- Ergänzen Sie eine eigene Regel für den Rechenzentrumskern, zuerst mit
simulate: true. - Behalten Sie
report: falsefür Crawl-Regeln bei und lassen Sie Privatkundenadressen aus dem Feed.
Regeln, der Testbefehl, Ignore-Muster und der Betriebsalltag des Agenten sind in der Betriebsdokumentation Schritt für Schritt beschrieben.
Fragen zu Bot-Fluten auf WordPress
Hätte Cloudflare diese Bot-Flut gestoppt?
Zum Teil. Eine Bot-Challenge vor dem Kalender filtert Clients ohne JavaScript heraus, und die Kalender-Crawler luden nicht einmal Stylesheets. Die Asset-Flut mit gefälschtem Referer sieht aus wie ein Browser und braucht auch dort eine Ratenregel oder eine Präfixsperre.
Soll ich Residential-Proxy-Adressen an eine Blacklist melden?
In der Regel nicht. Residential-Proxy-Ausgänge sind Festnetz- und Mobilfunkanschlüsse, oft hinter Carrier-Grade-NAT, und der Pool wechselt täglich. 225.000 davon zu melden würde gewöhnliche Kunden auf die Liste setzen und morgen niemanden schützen. Vertretbar sind nur die Rechenzentrumsadressen des harten Kerns, und nur als Bad-Bot-Meldung.
Warum sperrt der Agent keine ganzen Präfixe?
Weil ein /24 in einem Mobilfunknetz Tausende Kunden hinter Carrier-Grade-NAT tragen kann und ein einziger schlechter Client sie alle aussperren würde. Der Agent sperrt einzelne Adressen mit einer Eskalationsleiter. Eine Präfixsperre ist eine Entscheidung für einen Menschen mit dem whois-Eintrag vor Augen, umgesetzt in nginx oder der Firewall.