Flot de bots sur un calendrier WordPress : détection et contre-mesures
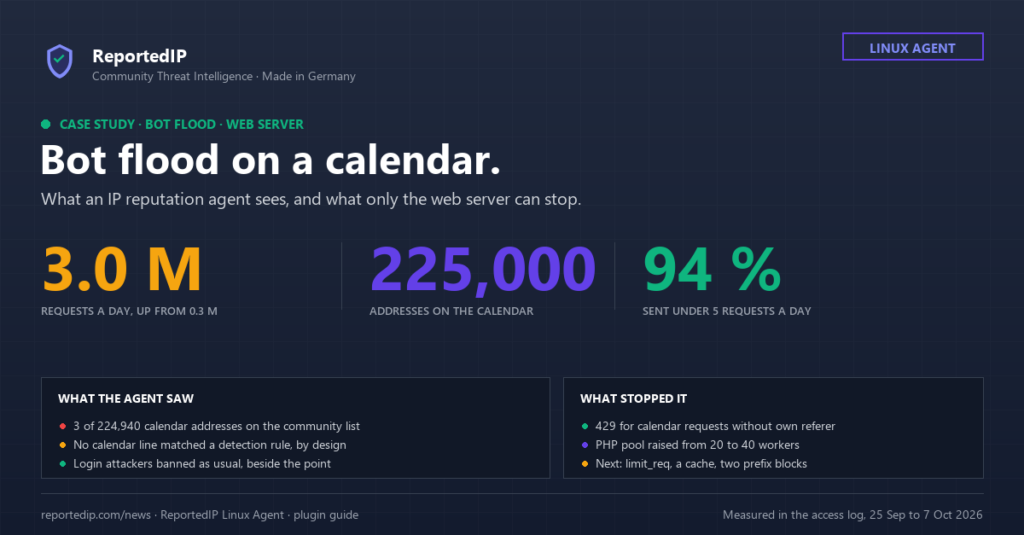
Un site WordPress doté d’un calendrier d’événements, hébergé sur un serveur mutualisé, est passé de moins de 400 000 requêtes par jour à environ trois millions ; son pool PHP a saturé et les visiteurs ont reçu des erreurs 502. Le ReportedIP Agent installé sur le même serveur a lu chaque ligne de ce flot de bots sans bannir une seule adresse à cause de lui, et ce guide explique pourquoi c’était juste et ce qui a arrêté le flot à sa place.
Les chiffres proviennent du journal d’accès du site, du 25 septembre au 7 octobre 2026, et d’une mesure sur cinq serveurs web. L’équipe d’hébergement a vu 38 870 connexions échouées vers PHP dans 200 000 lignes du journal d’erreurs. L’agent, lui, a vu des pages vues ordinaires.
Que s’est-il passé sur le site du calendrier ?
Jusqu’au 28 septembre, le site servait jusqu’à 364 000 requêtes par jour, pour la plupart des appels au filtre du calendrier /events/?mcat=… de l’extension My Calendar. Le 29 septembre à 07:00 UTC, le nombre de requêtes par heure est passé de 15 360 à 86 240, puis à 187 994 l’heure suivante. Les requêtes du calendrier sont restées stables ; le saut venait uniquement des ressources des pages.
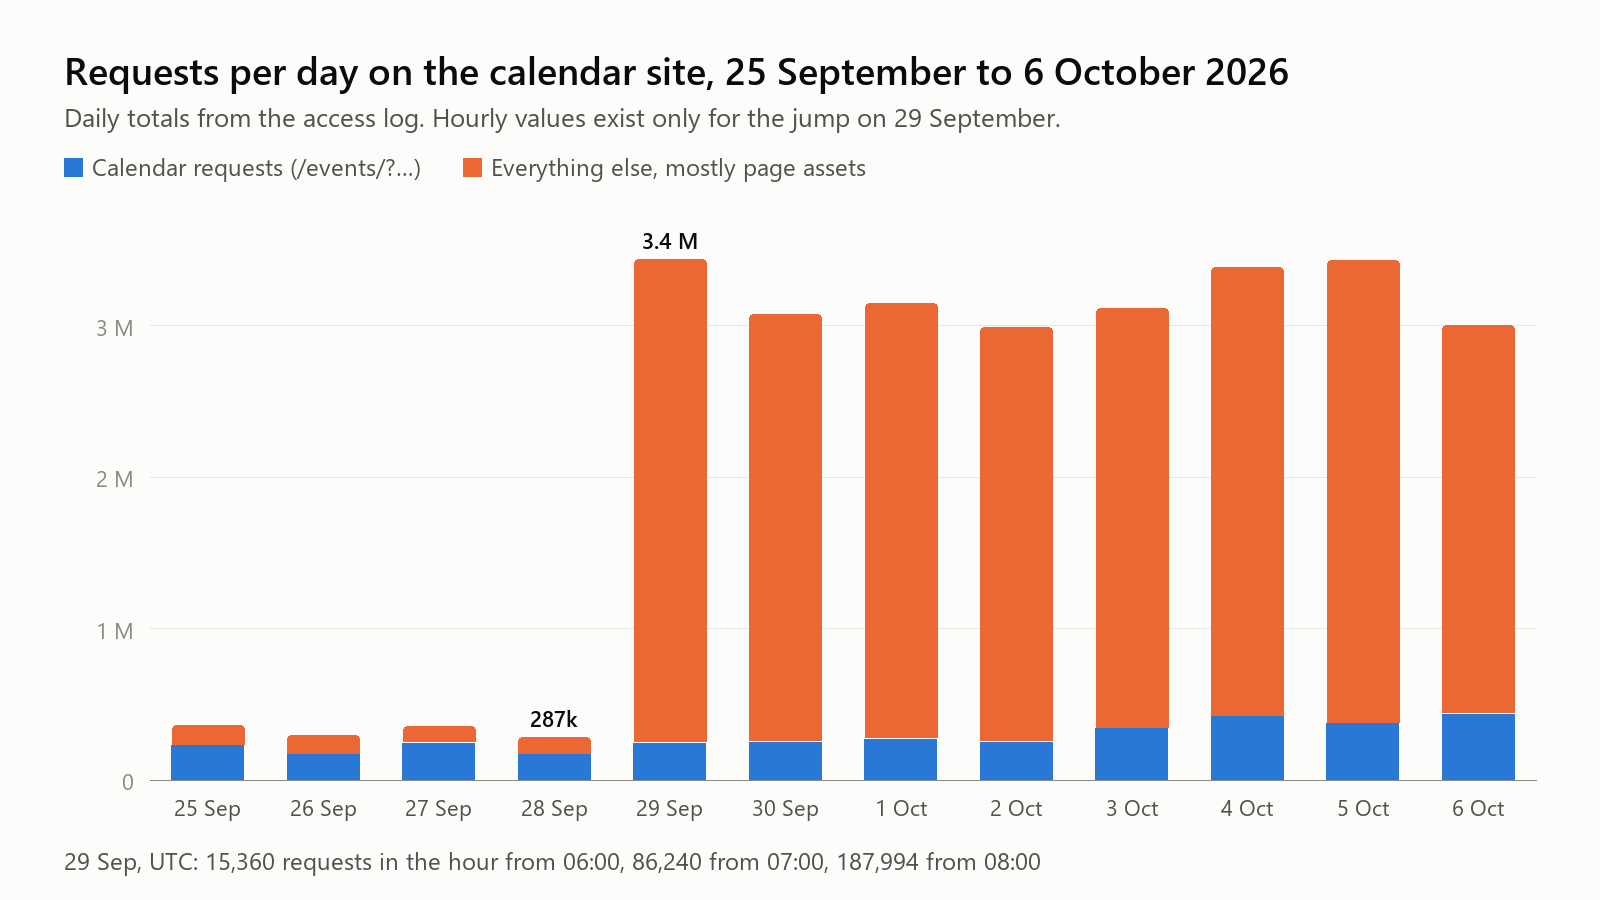
Le pool PHP autorisait 20 workers et a atteint cette limite 75 fois le 6 octobre ; ce jour-là, le calendrier a répondu à 30 129 requêtes par une erreur 502. Pendant huit jours, aucune alerte ne s’est déclenchée. L’équipe d’hébergement a ensuite doublé le pool et placé une règle devant le calendrier.
Quels bots se cachaient derrière le flot ?
Le crawl du calendrier via des proxys résidentiels
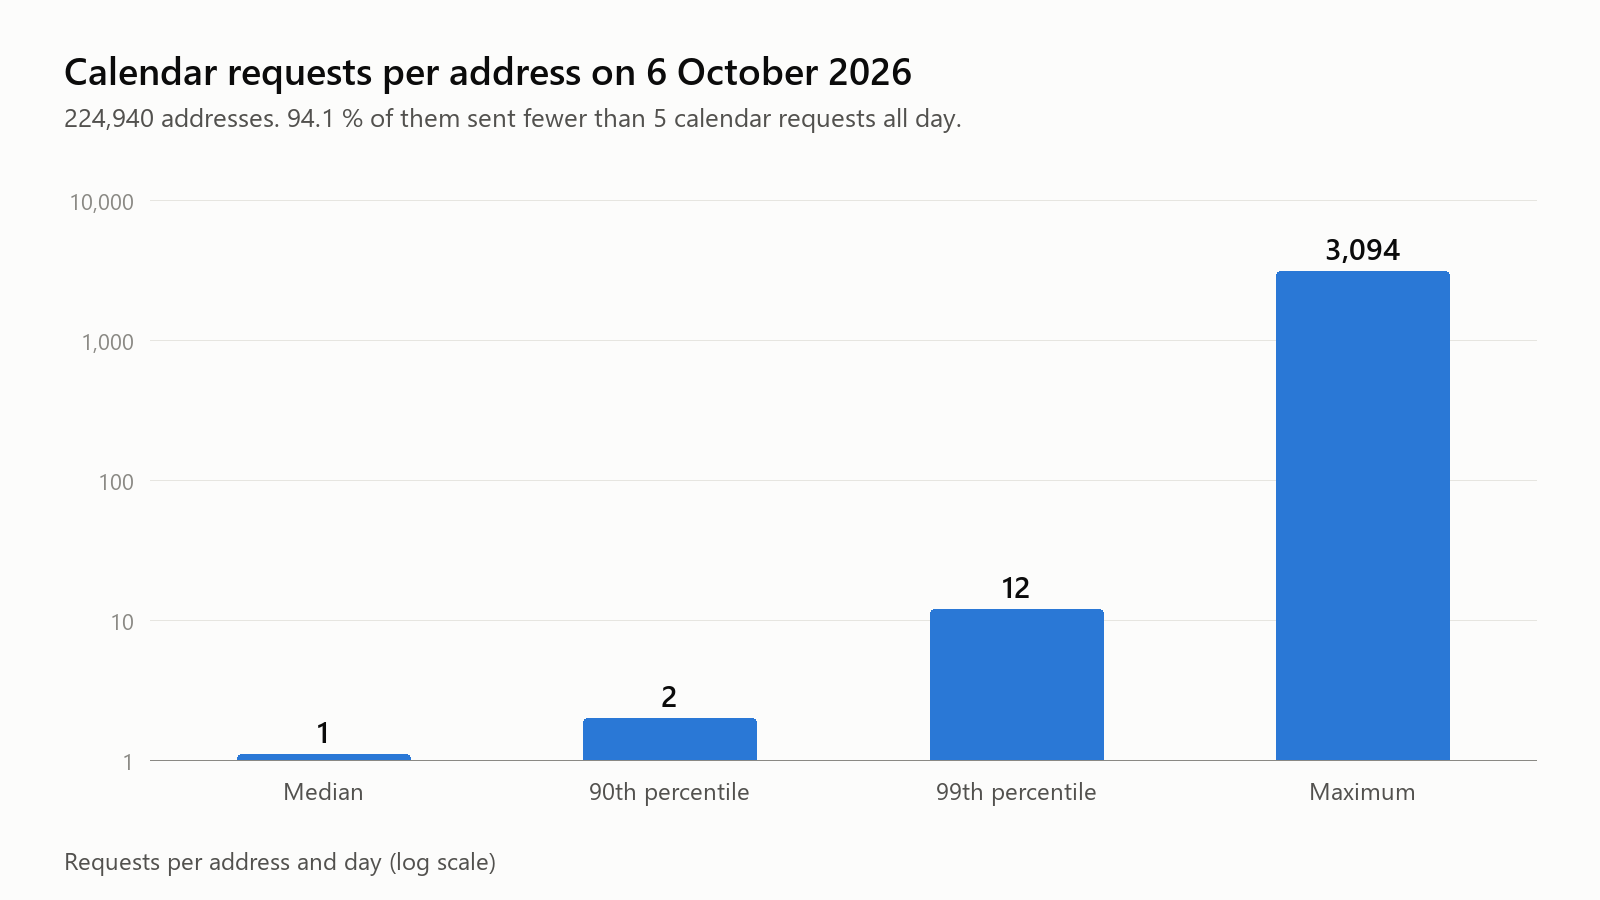
Le premier flux parcourait toutes les combinaisons de catégories, de jours et de mois du calendrier. Le 6 octobre, 224 940 adresses ont envoyé 432 855 requêtes au calendrier. La plupart des adresses sont apparues une fois, puis plus jamais.
| Crawl du calendrier, 6 octobre | Valeur |
|---|---|
| Adresses | 224 940 |
| Adresses avec moins de 5 requêtes sur la journée | 94,1 % |
| Requêtes par adresse, médiane | 1 |
| Requêtes par adresse, 99e centile | 12 |
| Requêtes par adresse, maximum | 3 094 |
| Réseaux /24 différents | 125 482 |
| Requêtes avec le site lui-même comme référent | 0,3 % |
Le plus grand réseau /16 regroupait 0,8 % des adresses. Cette dispersion sur des lignes fixes et mobiles est la signature d’un pool de proxys résidentiels. Les six user agents les plus fréquents se présentaient tous comme Chrome sur macOS, mais seules 987 adresses du calendrier ont chargé la moindre ressource ce jour-là.
Le flot de ressources issu de deux blocs loués
Le second flux demandait les ressources de pages ordinaires, avec l’adresse du site comme référent, comme le fait un navigateur. Il représentait 84,6 % de toutes les lignes du journal le 6 octobre.
| Flot de ressources, 6 octobre | Valeur |
|---|---|
| Requêtes de ressources | 2 543 994 |
| Adresses | 28 520 |
| Requêtes avec le site lui-même comme référent | 99,8 % |
| Ressources par adresse, médiane | 70 |
| Part venant de 154.222.128.0/20 | 21,1 % |
| Part venant de 154.217.192.0/20 | 19,1 % |
| Part des cinq user agents les plus fréquents | 48,9 % |
Cinq user agents avec presque le même nombre de requêtes chacun forment une liste en rotation, pas un vrai public. Dans le premier bloc /20, chaque /24 comptait 252 ou 253 adresses actives : un bloc loué, exploité jusqu’à la dernière adresse. Et les pages correspondant à ces ressources apparaissent à peine dans le journal, 29 281 pages vues contre 2,5 millions de ressources.
Pourquoi l’agent de réputation IP n’a-t-il pas arrêté le flot de bots ?
Parce qu’une requête réussie sur une page ordinaire n’est jamais une attaque, et l’agent est conçu ainsi volontairement. Sa source web compte les envois de formulaires de connexion, les chemins de scanners et les sondes qui finissent en erreur. Les requêtes au calendrier servies avec 200, 499 ou 502 ne correspondent à rien de tout cela, et le détecteur web écarte les ressources avant de les examiner. Un détecteur qui compte les pages vues bannit de vrais visiteurs.
La liste communautaire connaissait 3 des 224 940 adresses du calendrier et 1 des 28 520 adresses du flot de ressources ; les sorties de proxy fraîches ne figurent encore sur aucune liste. Pendant ce temps, l’agent faisait son travail habituel : 2 066 bannissements locaux en quatre jours et demi pour des tentatives de mots de passe, des sondes de scanners et des attaques SSH sur tous les sites du serveur. Juste, mais hors sujet.
Que peut faire l’agent contre un crawl de calendrier ?
Il peut retirer le noyau dur. Seize adresses issues de réseaux de centres de données ont envoyé chacune entre 1 162 et 3 094 requêtes au calendrier, lentement et régulièrement, environ trois par minute pendant sept à quatorze heures. Une règle personnelle voit la ligne de journal entière, chaîne de requête et référent compris, et peut donc compter exactement ces requêtes. Depuis 0.3.43, une règle peut d’abord être simulée : elle écrit simulated ban dans le journal au lieu de bannir. Depuis 0.3.45, une règle personnelle s’exécute avant les règles regex fournies de la même source ; jusqu’à 0.3.44, une règle fournie qui ne faisait que simuler pouvait prendre les lignes en premier.
Le bloc examples à la fin est l’autotest de la règle, pas une liste de cibles. Chaque ligne match doit correspondre et donner l’adresse indiquée ; la ligne inject place des adresses leurres dans l’URL et le user agent, et la règle doit tout de même lire l’adresse du client ; les lignes nomatch ne doivent pas compter. L’agent exécute ces contrôles au chargement du fichier et refuse la règle si l’un d’eux échoue. En service, la règle bannit toute adresse du vrai journal qui atteint 10 correspondances en 60 minutes. Le fichier ci-dessous est la règle qui tourne désormais sur deux sites à calendrier touchés. Elle y est armée (simulate: false), parce qu’elle a d’abord tourné en simulation et que ses correspondances ont été mesurées.
# /etc/reportedip-agent/rules.d/60-calendar-crawl.yaml
format: 1
rules:
  - id: calendar-crawl
    source: web
    match:
      regex: '"GET /[^" ]*\?[^" ]*mcat=[^"]*" [0-9]{3} [0-9]+ "(-|https?://(www\.)?(google|bing)\.[^"]*)" "Mozilla/[^"]*"$'
      anchors:
        - '"GET /'
      ignore:
        - 'mc_id='
        - '"[^"]*([Bb]ot|[Cc]rawl|[Ss]pider|Barkrowler|Turnitin|GoogleOther)[^"]*"$'
    addr: {field: 0}
    threshold: {hits: 10, window_minutes: 60}
    categories: [19]
    noun: calendar crawl requests
    action:
      ban: true
      report: false
      time_minutes: 60
      simulate: false
    # Self-test, not a target list: checked when the file loads; in operation the rule bans any address that reaches 10 hits in 60 minutes.
    examples:
      match:
        - {line: '45.33.32.156 - - [06/Oct/2026:12:00:00 +0000] "GET /events/?cid=my-calendar&dy=29&mcat=6%2C5%2C7&time=day HTTP/2.0" 200 5120 "-" "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7)"', addr: 45.33.32.156}
        - {line: '45.33.32.157 - - [06/Oct/2026:12:00:01 +0000] "GET /events/?mcat=7,1,12,3,8 HTTP/1.1" 429 162 "https://www.google.com/" "Mozilla/5.0 (Linux; Android 10; K)"', addr: 45.33.32.157}
        - {line: '45.33.32.158 - - [06/Oct/2026:12:00:02 +0000] "GET /kalender/?cid=my-calendar&mcat=6%2C5&yr=2026 HTTP/2.0" 200 5120 "-" "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/118.0.0.0 Safari/537.36"', addr: 45.33.32.158}
      inject:
        - {line: '45.33.32.156 - - [06/Oct/2026:12:00:03 +0000] "GET /events/?mcat=1&x=8.8.8.8 HTTP/1.1" 200 5120 "-" "Mozilla/5.0 8.8.4.4"', addr: 45.33.32.156}
      nomatch:
        - '45.33.32.156 - - [06/Oct/2026:12:00:10 +0000] "GET /events/?mcat=1 HTTP/2.0" 200 5120 "-" "RetroDocumentResearch/0.1"'
        - '45.33.32.156 - - [06/Oct/2026:12:00:04 +0000] "GET /events/?mcat=1 HTTP/2.0" 200 5120 "https://example.org/events/" "Mozilla/5.0"'
        - '45.33.32.156 - - [06/Oct/2026:12:00:05 +0000] "GET /kalender/?mc_id=123&mcat=1 HTTP/2.0" 200 5120 "-" "Mozilla/5.0"'
        - '45.33.32.156 - - [06/Oct/2026:12:00:06 +0000] "GET /kalender/?cid=my-calendar&mcat=6%2C5&yr=2026 HTTP/2.0" 200 5120 "-" "Mozilla/5.0 (compatible; Barkrowler/0.9; +https://babbar.tech/crawler)"'
        - '45.33.32.156 - - [06/Oct/2026:12:00:07 +0000] "GET /events/?mcat=1 HTTP/2.0" 200 5120 "-" "Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)"'
        - '45.33.32.156 - - [06/Oct/2026:12:00:08 +0000] "GET /events/?cid=my-calendar HTTP/2.0" 200 5120 "-" "Mozilla/5.0"'
        - '45.33.32.156 - - [06/Oct/2026:12:00:09 +0000] "POST /events/?mcat=1 HTTP/2.0" 200 5120 "-" "Mozilla/5.0"'
La règle compte toute requête avec mcat= dans la chaîne de requête, sur n’importe quel chemin, et convient donc aux calendriers sous /events/ comme sous /kalender/, et avec n’importe quel statut, pour qu’un crawl auquel le serveur web répond déjà par 429 compte toujours. Elle ne compte que les requêtes sans référent ou avec Google ou Bing comme référent : un visiteur qui parcourt vingt filtres porte le référent du site et ne compte jamais, et un lien vers un événement isolé (mc_id) est exclu. La règle ne compte que les clients dont le user agent commence par Mozilla/, ce qu’envoient tous les navigateurs et tous les crawlers déguisés ; un crawler ou un outil qui donne son propre nom n’est jamais compté, même s’il n’a pas de mot comme bot dans son nom, comme nous l’avons vu en direct, et la liste de noms attrape les crawlers qui commencent eux aussi par Mozilla/, comme Googlebot. report: false tient le crawl à l’écart du flux communautaire, time_minutes: 60 double le premier bannissement, et l’échelle d’escalade le multiplie par quatre jusqu’à sept jours. Vérifiez le fichier avec reportedip-agent rules check, essayez-le sur une journée de journal avec reportedip-agent test <log> --rule calendar-crawl, et commencez sur votre propre site avec simulate: true jusqu’à ce que les correspondances paraissent cohérentes.
Le 6 octobre, mesuré avec un premier projet à 20 requêtes par heure, au plus 69 adresses ont atteint ce niveau, et elles ont envoyé 9,4 % de la charge du calendrier. Les 90 % restants viennent d’adresses qui demandent tout au plus quelques fois puis disparaissent, et aucun comptage par adresse ne les distingue de personnes réelles.
Pourquoi les crawlers déclarés ne sont pas bannis
Nous avons mesuré une règle semblable mais plus large (toute chaîne de requête, statut 200 uniquement) sur cinq serveurs pendant deux jours. À 20 requêtes en 60 minutes, elle a touché 53 adresses : aucun humain ni aucun monitoring, mais 35 crawlers SEO et IA, un vrai moteur de recherche, un outil et 16 bots se faisant passer pour un navigateur ou pour un crawler connu. Sur le site touché, cette règle plus large a attrapé 46 des 69 adresses les plus actives, dont les 16 adresses de centres de données. Notre décision : une règle de crawl ne compte que les clients qui se font passer pour un navigateur. Un crawler qui donne son nom peut être un service SEO souscrit par le propriétaire du site lui-même, c’est pourquoi la deuxième ligne ignore l’écarte.
Écarter les crawlers nommés est une politique, pas un contrôle de sécurité. La mesure contenait une adresse qui se présentait comme Googlebot depuis un réseau d’hébergement, et la règle la laisse passer ; les détecteurs de connexion et de scanners continuent de la compter. Une vraie exception pour les moteurs de recherche exige une vérification DNS inverse, jamais le user agent. Pour un health check qui ne doit jamais compter, une ligne dans /etc/reportedip-agent/ignore.d/web.conf suffit, voir les lignes qu’une source ne doit jamais voir.
Qui est banni, et qui ne l’est pas ?
Une fois la règle armée sur les deux sites, le frein d’urgence 429 du serveur web a été retiré et nous avons observé l’heure suivante, le 7 octobre de 13:11 à 14:11 UTC. Le site A est le site à calendrier de ce cas ; le site B est un second site WordPress doté de la même extension de calendrier.
| Qui | Banni | Pourquoi |
|---|---|---|
| Six adresses d’un fournisseur cloud, toutes avec le même user agent Chrome sur macOS | Oui | Crawlaient le calendrier depuis minuit, 156 à 402 requêtes au calendrier chacune ce jour-là, sans référent du site, sans connexion, sans POST |
| Une adresse d’un second fournisseur cloud, user agent Android | Oui | Un crawler déguisé en navigateur, avec un référent Google falsifié |
| Crawlers déclarés comme Googlebot, bingbot, PetalBot, GPTBot, Reflectionbot et Barkrowler | Non | Un crawler qui dit qui il est pose une question de politique au propriétaire du site, ce n’est pas une attaque. Seuls les user agents commençant par Mozilla/ comptent, et la liste de noms écarte les crawlers comme Googlebot qui commencent ainsi eux aussi |
| Les personnes qui cliquent sur les filtres du calendrier | Non | Elles envoient le site lui-même comme référent |
| Le propre serveur du site et le monitoring | Non | Toujours sur la liste blanche |
| La longue traîne de l’essaim | Non | Des milliers d’adresses avec chacune une poignée de requêtes ; aucune règle par adresse ne les attrape sans toucher des personnes |
La précision a été de 7 sur 7 : aucun humain, aucun bon bot, et personne n’a dû être débanni. Après leur bannissement, les sept adresses n’ont plus envoyé aucune requête dans l’heure.
L’effet sur la charge est faible, et cela fait partie du tableau. Sur le site A, les sept adresses ont représenté 1,2 % des requêtes au calendrier de cette heure, 70 sur 5 901. Sur le site B, aucun crawler n’a dépassé 9 requêtes par adresse et par heure, sous le seuil, tandis qu’un crawler IA déclaré produisait à lui seul 28 % de la charge du calendrier. La règle le laisse tranquille ; le bloquer relève du propriétaire du site, dans le serveur web ou dans robots.txt. Aucun des deux sites n’a répondu par une erreur 5xx pendant cette heure, et le pool PHP du site A a utilisé au plus 14 de ses 40 workers.
La règle retire les crawlers bruyants déguisés en navigateur, avec une précision quasi certaine. L’essaim et les crawlers déclarés relèvent du serveur web, avec une limite de débit et un cache, et de la politique de crawl du propriétaire du site.
L’agent lit chaque journal de vhost d’un serveur Linux, bannit ce que ses règles désignent et synchronise la blacklist communautaire dans le noyau. Vos propres règles tournent à côté des règles fournies.
Comment arrêter un flot de bots avec nginx ?
Tout ce qui limite la charge quel que soit l’expéditeur relève du serveur web. Les extraits ci-dessous sont génériques ; adaptez le chemin, le domaine et les valeurs à votre site. Le détail de chaque directive figure dans la documentation nginx sur limit_req.
Limiter le calendrier dans son ensemble avec limit_req
Une zone par adresse ne sert à rien contre 225 000 adresses qui envoient une requête chacune ; la zone existante du serveur, 100 requêtes par seconde et par adresse, ne s’est jamais déclenchée. La zone utile a une clé fixe : PHP ne voit alors jamais plus qu’un nombre défini de requêtes au calendrier par seconde, quel que soit le nombre d’adresses qui les envoient.
# http {}
limit_req_zone $binary_remote_addr zone=calendar_ip:10m rate=1r/s;
limit_req_zone $server_name        zone=calendar_all:1m rate=10r/s;

# server {}
location ^~ /events/ {
    limit_req zone=calendar_ip  burst=5  nodelay;
    limit_req zone=calendar_all burst=20;
    limit_req_status 429;
    try_files $uri $uri/ /index.php?$args;
}
Mettre le calendrier en cache avec la chaîne de requête dans la clé
Un cache FastCGI dont la clé est l’URI complète répond aux appels de filtres répétés sans PHP. Il ne met rien en cache tant que WordPress envoie Set-Cookie ou Cache-Control: no-cache ; le réglage correspondant est fastcgi_ignore_headers. Avec des combinaisons de filtres pratiquement illimitées, son taux de succès de cache reste limité ; combinez-le donc avec moins de combinaisons : liens de filtre en rel="nofollow", chemin du filtre dans robots.txt, ou filtres par script plutôt que par lien.
# http {}
fastcgi_cache_path /var/cache/nginx/calendar levels=1:2 keys_zone=calendar:10m max_size=1g inactive=10m;

# inside the PHP location of the server
set $skip_cache 1;
if ($request_uri ~ "^/events/\?") { set $skip_cache 0; }
if ($http_cookie ~* "wordpress_logged_in|wp-postpass|comment_author") { set $skip_cache 1; }
fastcgi_cache        calendar;
fastcgi_cache_key    "$scheme$request_method$host$request_uri";
fastcgi_cache_valid  200 5m;
fastcgi_cache_lock   on;
fastcgi_cache_bypass $skip_cache;
fastcgi_no_cache     $skip_cache;
Répondre 429 aux requêtes du calendrier sans référent du site
C’est la règle que l’équipe d’hébergement a activée, comme frein d’urgence. Le 6 octobre, 99,7 % des requêtes au calendrier arrivaient sans le référent du site. Dans la première heure complète avec la règle, 29 170 des 29 208 requêtes au calendrier ont reçu une 429. Elle ne tient que jusqu’à ce que le bot falsifie le référent, ce que fait déjà le flot de ressources.
# http {}
map $http_referer $own_referer {
    default 0;
    "~^https://(www\.)?example\.org/" 1;
}
map "$own_referer:$arg_mc_id:$args" $calendar_brake {
    default 0;
    "~^0::.+" 1;   # no own referer, no single event, but a query string
}

# server {}, inside location ^~ /events/
if ($calendar_brake) { return 429; }
Bloquer les préfixes loués après une vérification whois
Les deux blocs /20 portaient 40 % du flot de ressources. Vérifiez d’abord le titulaire avec whois : un hébergeur peut être bloqué en entier, un fournisseur d’accès grand public non.
# server {}, only after whois names a hosting provider
deny 154.222.128.0/20;
deny 154.217.192.0/20;
Placer un challenge anti-bot ou un service en amont
Distinguer un navigateur headless d’une personne demande du JavaScript ou du fingerprinting, ce que ne font ni un lecteur de journaux ni nginx. Un reverse proxy avec challenge anti-bot, ou un challenge devant le filtre du calendrier, est la dernière étape quand le frein sur le référent ne tient plus.
Checklist pour les exploitants d’un calendrier WordPress
- Surveillez le nombre de requêtes par vhost et par heure, pas seulement le journal d’erreurs.
- Séparez requêtes au calendrier, ressources et pages dans le journal d’accès avant d’agir.
- Vérifiez si les clients chargent les ressources. Les crawlers déguisés en navigateur ne le font généralement pas.
- Placez une zone
limit_reqà clé fixe sur le chemin du filtre. - Mettez le chemin du filtre en cache avec la chaîne de requête dans la clé de cache.
- Retirez les liens de filtre du crawl avec
nofollowetrobots.txt. - N’utilisez la réponse 429 pour les requêtes sans référent du site que comme frein d’urgence.
- Ne bloquez un préfixe qu’après que whois a montré un hébergeur.
- Ajoutez une règle personnelle pour le noyau issu des centres de données, d’abord avec
simulate: true. - Gardez
report: falsepour les règles de crawl et laissez les adresses résidentielles hors du flux.
Les règles, la commande de test, les motifs d’exclusion et l’exploitation quotidienne de l’agent sont décrits pas à pas dans la documentation d’exploitation.
Questions sur les flots de bots sous WordPress
Cloudflare aurait-il arrêté ce flot de bots ?
En partie. Un challenge anti-bot devant le calendrier écarte les clients sans JavaScript, et les crawlers du calendrier ne chargeaient même pas les feuilles de style. Le flot de ressources au référent falsifié ressemble à un navigateur et demande, là aussi, une règle de débit ou un blocage de préfixe.
Faut-il signaler les adresses de proxys résidentiels à une blacklist ?
En règle générale, non. Les sorties de proxys résidentiels sont des connexions fixes et mobiles de particuliers, souvent derrière un NAT d’opérateur, et le pool change chaque jour. En signaler 225 000 mettrait des clients ordinaires sur la liste sans protéger personne le lendemain. Seules les adresses de centres de données du noyau dur sont défendables, et seulement comme signalement de mauvais bot.
Pourquoi l’agent ne bannit-il pas des préfixes entiers ?
Parce qu’un /24 dans un réseau mobile peut abriter des milliers de clients derrière un NAT d’opérateur, et qu’un seul mauvais client les exclurait tous. L’agent bannit des adresses isolées avec une échelle d’escalade. Bloquer un préfixe est une décision humaine, prise avec l’enregistrement whois sous les yeux et appliquée dans nginx ou le pare-feu.