Avalancha de bots en un calendario WordPress: detección y contramedidas
Un sitio WordPress con un calendario de eventos en un servidor de hosting compartido pasó de menos de 400.000 peticiones al día a unos tres millones, su pool de PHP se llenó y los visitantes recibieron errores 502. El ReportedIP Agent del mismo servidor leyó cada línea de esa avalancha de bots y no bloqueó ninguna dirección por ella; esta guía explica por qué fue lo correcto y qué detuvo la avalancha en su lugar.
Las cifras salen del registro de acceso del sitio, del 25 de septiembre al 7 de octubre de 2026, y de una medición en cinco servidores web. El equipo de hosting vio 38.870 conexiones fallidas a PHP en 200.000 líneas del registro de errores. El agente vio visitas a páginas normales.
¿Qué pasó en el sitio del calendario?
Hasta el 28 de septiembre el sitio atendía hasta 364.000 peticiones al día, la mayoría llamadas al filtro del calendario /events/?mcat=… del plugin My Calendar. El 29 de septiembre a las 07:00 UTC la cifra por hora saltó de 15.360 a 86.240, y una hora después a 187.994. Las peticiones al calendario no cambiaron; el salto vino solo de los recursos de las páginas.
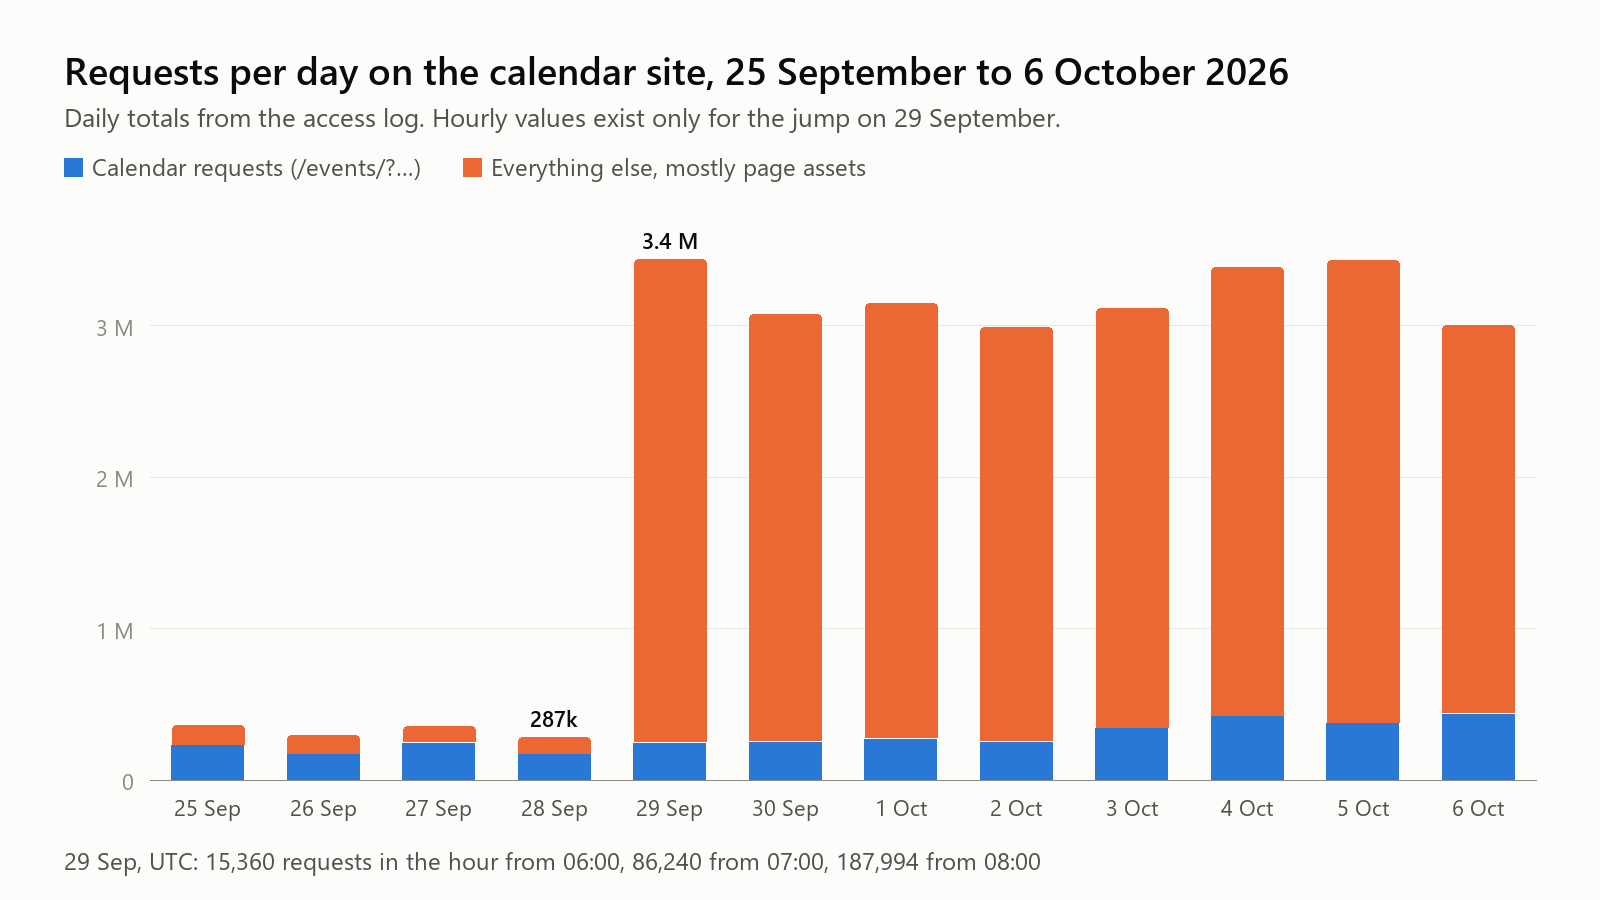
El pool de PHP admitía 20 workers y tocó ese límite 75 veces el 6 de octubre; ese día el calendario respondió a 30.129 peticiones con un 502. Durante ocho días no saltó ninguna alarma. Después el equipo de hosting duplicó el pool y puso una regla delante del calendario.
¿Qué bots había detrás de la avalancha?
El rastreo del calendario a través de proxies residenciales
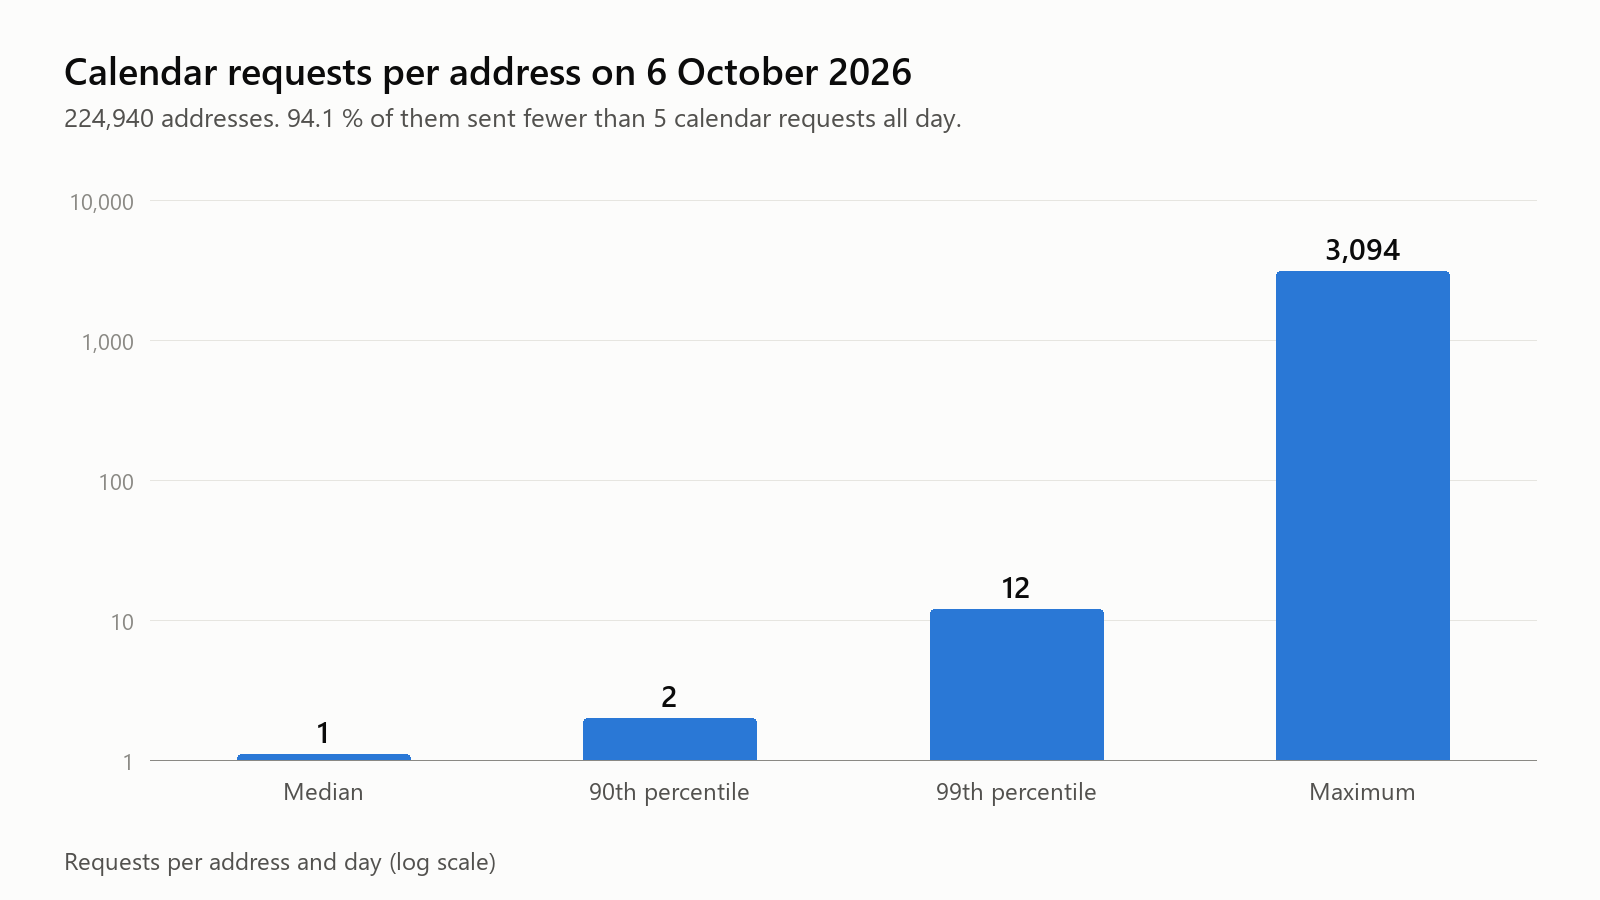
El primer flujo recorría todas las combinaciones de categorías, días y meses del calendario. El 6 de octubre, 224.940 direcciones enviaron 432.855 peticiones al calendario. La mayoría de las direcciones apareció una vez y nunca más.
| Rastreo del calendario, 6 de octubre | Valor |
|---|---|
| Direcciones | 224.940 |
| Direcciones con menos de 5 peticiones en todo el día | 94,1 % |
| Peticiones por dirección, mediana | 1 |
| Peticiones por dirección, percentil 99 | 12 |
| Peticiones por dirección, máximo | 3.094 |
| Redes /24 distintas | 125.482 |
| Peticiones con el propio sitio como referer | 0,3 % |
La red /16 más grande reunía el 0,8 % de las direcciones. Esa dispersión por conexiones domésticas y móviles es la firma de un pool de proxies residenciales. Los seis user agents más frecuentes decían ser Chrome en macOS, pero solo 987 direcciones del calendario cargaron algún recurso ese día.
La avalancha de recursos desde dos bloques alquilados
El segundo flujo pedía los recursos de páginas normales, con la dirección del propio sitio como referer, igual que un navegador. Supuso el 84,6 % de todas las líneas del registro el 6 de octubre.
| Avalancha de recursos, 6 de octubre | Valor |
|---|---|
| Peticiones de recursos | 2.543.994 |
| Direcciones | 28.520 |
| Peticiones con el propio sitio como referer | 99,8 % |
| Recursos por dirección, mediana | 70 |
| Parte desde 154.222.128.0/20 | 21,1 % |
| Parte desde 154.217.192.0/20 | 19,1 % |
| Parte de los cinco user agents más frecuentes | 48,9 % |
Cinco user agents con casi el mismo número de peticiones cada uno son una lista rotada, no un público real. En el primer bloque /20 cada /24 mostraba 252 o 253 direcciones activas: un bloque alquilado y usado hasta la última dirección. Y las páginas de esos recursos apenas aparecen en el registro, 29.281 visitas a páginas frente a 2,5 millones de recursos.
¿Por qué el agente de reputación IP no detuvo la avalancha de bots?
Porque una petición correcta a una página normal nunca es un ataque, y el agente está hecho así a propósito. Su fuente web cuenta envíos del formulario de inicio de sesión, rutas de escáneres y sondeos que acaban en error. Las peticiones al calendario respondidas con 200, 499 o 502 no encajan en nada de eso, y el detector web descarta los recursos antes de mirarlos. Un detector que cuenta visitas a páginas bloquea a visitantes reales.
La lista de la comunidad conocía 3 de las 224.940 direcciones del calendario y 1 de las 28.520 direcciones de recursos; las salidas de proxy recién estrenadas aún no están en ninguna lista. Mientras tanto, el agente hizo su trabajo de siempre: 2.066 bloqueos locales en cuatro días y medio por adivinación de contraseñas, sondeos de escáneres y ataques SSH en todos los sitios del servidor. Correcto, y fuera del tema.
¿Qué puede hacer el agente contra un rastreo del calendario?
Puede sacar el núcleo duro. Dieciséis direcciones de redes de centros de datos enviaron entre 1.162 y 3.094 peticiones al calendario cada una, despacio y de forma regular, unas tres por minuto durante siete a catorce horas. Una regla propia ve la línea entera del registro, incluidos la cadena de consulta y el referer, así que puede contar justo esas peticiones. Desde 0.3.43 una regla se puede simular primero: escribe simulated ban en el registro en lugar de bloquear. Desde 0.3.45 una regla propia se ejecuta antes que las reglas regex incluidas de la misma fuente; hasta 0.3.44 una regla incluida que solo simulaba podía quedarse antes con las líneas.
El bloque examples del final es la autoprueba de la regla, no una lista de objetivos. Cada línea match tiene que coincidir y dar la dirección indicada; la línea inject mete direcciones señuelo en la URL y en el user agent, y la regla aun así tiene que leer la dirección del cliente; las líneas nomatch no deben contar. El agente ejecuta estas comprobaciones al cargar el archivo y rechaza la regla si una falla. En funcionamiento, la regla bloquea cualquier dirección del registro real que llegue a 10 coincidencias en 60 minutos. El archivo de abajo es la regla que funciona ahora en dos sitios de calendario afectados. Allí está armada (simulate: false) porque primero funcionó en simulación y sus coincidencias se midieron.
# /etc/reportedip-agent/rules.d/60-calendar-crawl.yaml
format: 1
rules:
  - id: calendar-crawl
    source: web
    match:
      regex: '"GET /[^" ]*\?[^" ]*mcat=[^"]*" [0-9]{3} [0-9]+ "(-|https?://(www\.)?(google|bing)\.[^"]*)" "Mozilla/[^"]*"$'
      anchors:
        - '"GET /'
      ignore:
        - 'mc_id='
        - '"[^"]*([Bb]ot|[Cc]rawl|[Ss]pider|Barkrowler|Turnitin|GoogleOther)[^"]*"$'
    addr: {field: 0}
    threshold: {hits: 10, window_minutes: 60}
    categories: [19]
    noun: calendar crawl requests
    action:
      ban: true
      report: false
      time_minutes: 60
      simulate: false
    # Self-test, not a target list: checked when the file loads; in operation the rule bans any address that reaches 10 hits in 60 minutes.
    examples:
      match:
        - {line: '45.33.32.156 - - [06/Oct/2026:12:00:00 +0000] "GET /events/?cid=my-calendar&dy=29&mcat=6%2C5%2C7&time=day HTTP/2.0" 200 5120 "-" "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7)"', addr: 45.33.32.156}
        - {line: '45.33.32.157 - - [06/Oct/2026:12:00:01 +0000] "GET /events/?mcat=7,1,12,3,8 HTTP/1.1" 429 162 "https://www.google.com/" "Mozilla/5.0 (Linux; Android 10; K)"', addr: 45.33.32.157}
        - {line: '45.33.32.158 - - [06/Oct/2026:12:00:02 +0000] "GET /kalender/?cid=my-calendar&mcat=6%2C5&yr=2026 HTTP/2.0" 200 5120 "-" "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/118.0.0.0 Safari/537.36"', addr: 45.33.32.158}
      inject:
        - {line: '45.33.32.156 - - [06/Oct/2026:12:00:03 +0000] "GET /events/?mcat=1&x=8.8.8.8 HTTP/1.1" 200 5120 "-" "Mozilla/5.0 8.8.4.4"', addr: 45.33.32.156}
      nomatch:
        - '45.33.32.156 - - [06/Oct/2026:12:00:10 +0000] "GET /events/?mcat=1 HTTP/2.0" 200 5120 "-" "RetroDocumentResearch/0.1"'
        - '45.33.32.156 - - [06/Oct/2026:12:00:04 +0000] "GET /events/?mcat=1 HTTP/2.0" 200 5120 "https://example.org/events/" "Mozilla/5.0"'
        - '45.33.32.156 - - [06/Oct/2026:12:00:05 +0000] "GET /kalender/?mc_id=123&mcat=1 HTTP/2.0" 200 5120 "-" "Mozilla/5.0"'
        - '45.33.32.156 - - [06/Oct/2026:12:00:06 +0000] "GET /kalender/?cid=my-calendar&mcat=6%2C5&yr=2026 HTTP/2.0" 200 5120 "-" "Mozilla/5.0 (compatible; Barkrowler/0.9; +https://babbar.tech/crawler)"'
        - '45.33.32.156 - - [06/Oct/2026:12:00:07 +0000] "GET /events/?mcat=1 HTTP/2.0" 200 5120 "-" "Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)"'
        - '45.33.32.156 - - [06/Oct/2026:12:00:08 +0000] "GET /events/?cid=my-calendar HTTP/2.0" 200 5120 "-" "Mozilla/5.0"'
        - '45.33.32.156 - - [06/Oct/2026:12:00:09 +0000] "POST /events/?mcat=1 HTTP/2.0" 200 5120 "-" "Mozilla/5.0"'
La regla cuenta cada petición con mcat= en la cadena de consulta, en cualquier ruta, así que sirve para calendarios bajo /events/ igual que bajo /kalender/, y con cualquier estado, para que un rastreo al que el servidor web ya responde con 429 siga contando. Solo cuenta peticiones sin referer o con Google o Bing como referer: un visitante que pasa por veinte filtros lleva el referer del propio sitio y nunca cuenta, y un enlace a un evento concreto (mc_id) queda fuera. La regla solo cuenta clientes cuyo user agent empieza por Mozilla/, que es lo que envían todos los navegadores y todos los crawlers disfrazados; un crawler o una herramienta que da su propio nombre nunca cuenta, aunque su nombre no lleve una palabra como bot, como vimos en directo, y la lista de nombres atrapa a los crawlers que también empiezan por Mozilla/, como Googlebot. report: false mantiene el rastreo fuera del feed de la comunidad, time_minutes: 60 duplica el primer bloqueo y la escalera de escalado lo multiplica por cuatro hasta siete días. Compruébala con reportedip-agent rules check, pruébala con un día de registro mediante reportedip-agent test <log> --rule calendar-crawl y en tu propio sitio empieza con simulate: true hasta que las coincidencias parezcan coherentes.
El 6 de octubre, medido con un primer borrador de 20 peticiones por hora, como mucho 69 direcciones llegaron a ese nivel, y enviaron el 9,4 % de la carga del calendario. El 90 % restante viene de direcciones que preguntan unas pocas veces como mucho y se van, y ningún recuento por dirección las distingue de personas.
Por qué no se bloquea a los crawlers declarados
Medimos una regla parecida y más amplia (cualquier cadena de consulta, solo estado 200) en cinco servidores durante dos días. Con 20 peticiones en 60 minutos alcanzó 53 direcciones: ningún humano ni monitorización, pero sí 35 crawlers de SEO e IA, un buscador real, una herramienta y 16 bots que se hacían pasar por navegador o por un crawler conocido. En el sitio afectado esa regla más amplia atrapó 46 de las 69 direcciones más activas, entre ellas las 16 de centros de datos. Nuestra decisión: una regla de rastreo solo cuenta clientes que se hacen pasar por navegador. Un crawler que da su nombre puede ser un servicio de SEO que contrató el propio dueño del sitio, por eso la segunda línea ignore lo salta.
Saltar a los crawlers con nombre es una política, no un control de seguridad. La medición incluía una dirección que decía ser Googlebot desde una red de hosting, y la regla la deja pasar; los detectores de inicio de sesión y de escáneres la siguen contando. Una excepción real para buscadores necesita una comprobación de DNS inverso, nunca el user agent. Para un health check que no debe contar nunca, basta una línea en /etc/reportedip-agent/ignore.d/web.conf, mira las líneas que una fuente nunca debe ver.
¿A quién se bloquea y a quién no?
Con la regla armada en los dos sitios, se quitó el freno de emergencia 429 del servidor web y observamos la hora siguiente, el 7 de octubre de 13:11 a 14:11 UTC. El sitio A es el sitio de calendario de este caso; el sitio B es un segundo sitio WordPress con el mismo plugin de calendario.
| Quién | Bloqueado | Por qué |
|---|---|---|
| Seis direcciones de un proveedor cloud, todas con el mismo user agent de Chrome en macOS | Sí | Rastreaban el calendario desde medianoche, de 156 a 402 peticiones al calendario cada una ese día, sin referer propio, sin inicios de sesión, sin POST |
| Una dirección de un segundo proveedor cloud, user agent de Android | Sí | Un crawler que se hace pasar por navegador, con un referer de Google falsificado |
| Crawlers declarados como Googlebot, bingbot, PetalBot, GPTBot, Reflectionbot y Barkrowler | No | Un crawler que dice quién es plantea una cuestión de política para el dueño del sitio, no un ataque. Solo cuentan los user agents que empiezan por Mozilla/, y la lista de nombres salta a crawlers como Googlebot que también empiezan así |
| Personas que pulsan los filtros del calendario | No | Envían el propio sitio como referer |
| El servidor del propio sitio y la monitorización | No | Siempre en la lista blanca |
| La larga cola del enjambre | No | Miles de direcciones con un puñado de peticiones cada una; ninguna regla por dirección las atrapa sin dar a personas |
La precisión fue de 7 de 7: ningún humano, ningún bot bueno, y no hubo que desbloquear a nadie. Tras su bloqueo, las siete direcciones no enviaron ninguna petición más en esa hora.
El efecto sobre la carga es pequeño, y eso forma parte del cuadro. En el sitio A las siete direcciones supusieron el 1,2 % de las peticiones al calendario de esa hora, 70 de 5.901. En el sitio B ningún crawler pasó de 9 peticiones por dirección y hora, por debajo del umbral, mientras un crawler de IA declarado producía él solo el 28 % de la carga del calendario. La regla no lo toca; bloquearlo lo decide el dueño del sitio, en el servidor web o en robots.txt. Ninguno de los dos sitios respondió con un 5xx en esa hora, y el pool de PHP del sitio A usó como mucho 14 de sus 40 workers.
La regla quita a los crawlers ruidosos que se hacen pasar por navegador, con una precisión casi segura. El enjambre y los crawlers declarados corresponden al servidor web, con un límite de tasa y una caché, y a la política de crawlers del dueño del sitio.
El agente lee cada registro de vhost de un servidor Linux, bloquea lo que nombran sus reglas y sincroniza la blacklist de la comunidad en el núcleo. Tus propias reglas funcionan junto a las incluidas.
¿Cómo se detiene una avalancha de bots en nginx?
Todo lo que limita la carga sin importar quién la envía pertenece al servidor web. Los fragmentos de abajo son genéricos; adapta la ruta, el dominio y las cifras a tu sitio. El detalle de cada directiva está en la documentación de nginx sobre limit_req.
Limitar el calendario en conjunto con limit_req
Una zona por dirección no sirve contra 225.000 direcciones con una petición cada una; la zona que ya tenía el servidor, 100 peticiones por segundo y dirección, nunca saltó. La zona útil tiene una clave fija, de modo que PHP nunca ve más de un número fijado de peticiones al calendario por segundo, las envíen cuantas direcciones las envíen.
# http {}
limit_req_zone $binary_remote_addr zone=calendar_ip:10m rate=1r/s;
limit_req_zone $server_name        zone=calendar_all:1m rate=10r/s;

# server {}
location ^~ /events/ {
    limit_req zone=calendar_ip  burst=5  nodelay;
    limit_req zone=calendar_all burst=20;
    limit_req_status 429;
    try_files $uri $uri/ /index.php?$args;
}
Cachear el calendario con la cadena de consulta en la clave
Una caché FastCGI con la URI completa como clave responde sin PHP a las llamadas de filtro repetidas. No guarda nada mientras WordPress envíe Set-Cookie o Cache-Control: no-cache; el ajuste para eso es fastcgi_ignore_headers. Con combinaciones de filtros prácticamente ilimitadas su tasa de aciertos sigue siendo limitada, así que combínala con menos combinaciones: enlaces de filtro con rel="nofollow", la ruta del filtro en robots.txt o filtros por script en lugar de por enlace.
# http {}
fastcgi_cache_path /var/cache/nginx/calendar levels=1:2 keys_zone=calendar:10m max_size=1g inactive=10m;

# inside the PHP location of the server
set $skip_cache 1;
if ($request_uri ~ "^/events/\?") { set $skip_cache 0; }
if ($http_cookie ~* "wordpress_logged_in|wp-postpass|comment_author") { set $skip_cache 1; }
fastcgi_cache        calendar;
fastcgi_cache_key    "$scheme$request_method$host$request_uri";
fastcgi_cache_valid  200 5m;
fastcgi_cache_lock   on;
fastcgi_cache_bypass $skip_cache;
fastcgi_no_cache     $skip_cache;
Responder 429 a las peticiones al calendario sin el referer del sitio
Es la regla que activó el equipo de hosting, como freno de emergencia. El 6 de octubre el 99,7 % de las peticiones al calendario llegaba sin el referer del propio sitio. En la primera hora completa con la regla, 29.170 de 29.208 peticiones al calendario recibieron un 429. Solo aguanta hasta que el bot falsifica el referer, cosa que el flujo de recursos ya hace.
# http {}
map $http_referer $own_referer {
    default 0;
    "~^https://(www\.)?example\.org/" 1;
}
map "$own_referer:$arg_mc_id:$args" $calendar_brake {
    default 0;
    "~^0::.+" 1;   # no own referer, no single event, but a query string
}

# server {}, inside location ^~ /events/
if ($calendar_brake) { return 429; }
Bloquear prefijos alquilados tras consultar whois
Los dos bloques /20 llevaban el 40 % de la avalancha de recursos. Consulta antes el titular con whois: a un proveedor de hosting puedes bloquearlo entero, a un proveedor de acceso doméstico no.
# server {}, only after whois names a hosting provider
deny 154.222.128.0/20;
deny 154.217.192.0/20;
Poner delante un desafío antibots o un servicio intermedio
Distinguir un navegador headless de una persona exige JavaScript o fingerprinting, y eso no lo hace ni un lector de registros ni nginx. Un proxy inverso con desafío antibots, o un desafío delante del filtro del calendario, es el último paso cuando el freno por referer deja de funcionar.
Lista de comprobación para quien gestiona un calendario WordPress
- Vigila las peticiones por vhost y por hora, no solo el registro de errores.
- Separa en el registro de acceso las peticiones al calendario, los recursos y las páginas antes de actuar.
- Comprueba si los clientes cargan recursos. Los crawlers que se hacen pasar por navegador no suelen hacerlo.
- Pon una zona
limit_reqcon clave fija en la ruta del filtro. - Cachea la ruta del filtro con la cadena de consulta en la clave de caché.
- Saca los enlaces de filtro del rastreo con
nofollowyrobots.txt. - Usa el 429 para peticiones sin el referer del sitio solo como freno de emergencia.
- Bloquea un prefijo solo cuando whois muestre un proveedor de hosting.
- Añade una regla propia para el núcleo de centros de datos, primero con
simulate: true. - Mantén
report: falseen las reglas de rastreo y deja las direcciones residenciales fuera del feed.
Las reglas, el comando de prueba, los patrones de exclusión y el trabajo diario con el agente se describen paso a paso en la documentación de operación.
Preguntas sobre avalanchas de bots en WordPress
¿Habría detenido Cloudflare esta avalancha de bots?
En parte. Un desafío antibots delante del calendario filtra a los clientes sin JavaScript, y los crawlers del calendario ni siquiera cargaban hojas de estilo. La avalancha de recursos con referer falsificado parece un navegador y también allí necesita una regla de tasa o un bloqueo de prefijo.
¿Debo notificar direcciones de proxies residenciales a una blacklist?
Por norma, no. Las salidas de proxies residenciales son conexiones domésticas y móviles, a menudo tras un NAT de operador, y el pool cambia cada día. Notificar 225.000 pondría a clientes normales en la lista y mañana no protegería a nadie. Solo son defendibles las direcciones de centros de datos del núcleo duro, y solo como notificación de bot malicioso.
¿Por qué el agente no bloquea prefijos enteros?
Porque un /24 de una red móvil puede alojar miles de clientes tras un NAT de operador, y un solo cliente malo los dejaría fuera a todos. El agente bloquea direcciones sueltas con una escalera de escalado. Bloquear un prefijo es una decisión de una persona con el registro whois delante, y la ejecutan nginx o el cortafuegos.